ナレッジベースの構築
この章で扱うこと
Knowledge タブの Source Ingest は、変換済みの Markdown を読んでナレッジベース(オントロジーページ)を作ります。この章では、Source Ingest を実行する方法、実行中と完了後の画面の読み方、作られたページを確認する方法、そして文書から抽出された図にキャプションを付ける方法を扱います。
- 対象読者: 入力文書の Markdown 変換を終えたユーザー
- 前提条件: 前の章で作られた
Wiki/raw/<文書>/<文書>.md
Ingest と Caption figures は Claude を呼び出し、課金されます。 Ingest は AI の接続状態を確認せずに実行されるため、接続なしで実行するとモデル呼び出しが失敗し、
not connectedを含む警告が残ります。実行前にヘッダーの AI 状態が緑の点であることを確認してください。
Source Ingest を実行する
- ① Knowledge タブを押します。左のレールにアイコンが 4 つ(Knowledge、Ingest、Index、Graph)あり、2 番目の Ingest アイコンが Source Ingest 画面です。
- 画面下の Input Documents 表で、変換済みの
.mdファイルの Status が Ready であることを確認します。Ready は対応形式で、まだインジェストされていないという意味です(Ingested = インジェスト済み、Skipped = 変換ログなどのメタデータファイル、Unsupported = 未対応の拡張子)。 - ② 右上の 2 つのドロップダウンでモデルと effort を選びます。既定値は Default · sonnet と Default · high で、モデルは opus / sonnet / haiku、effort は low / medium / high から変更できます。
- ③ Run Ingest を押します。実行中はボタンが Ingesting に変わります。
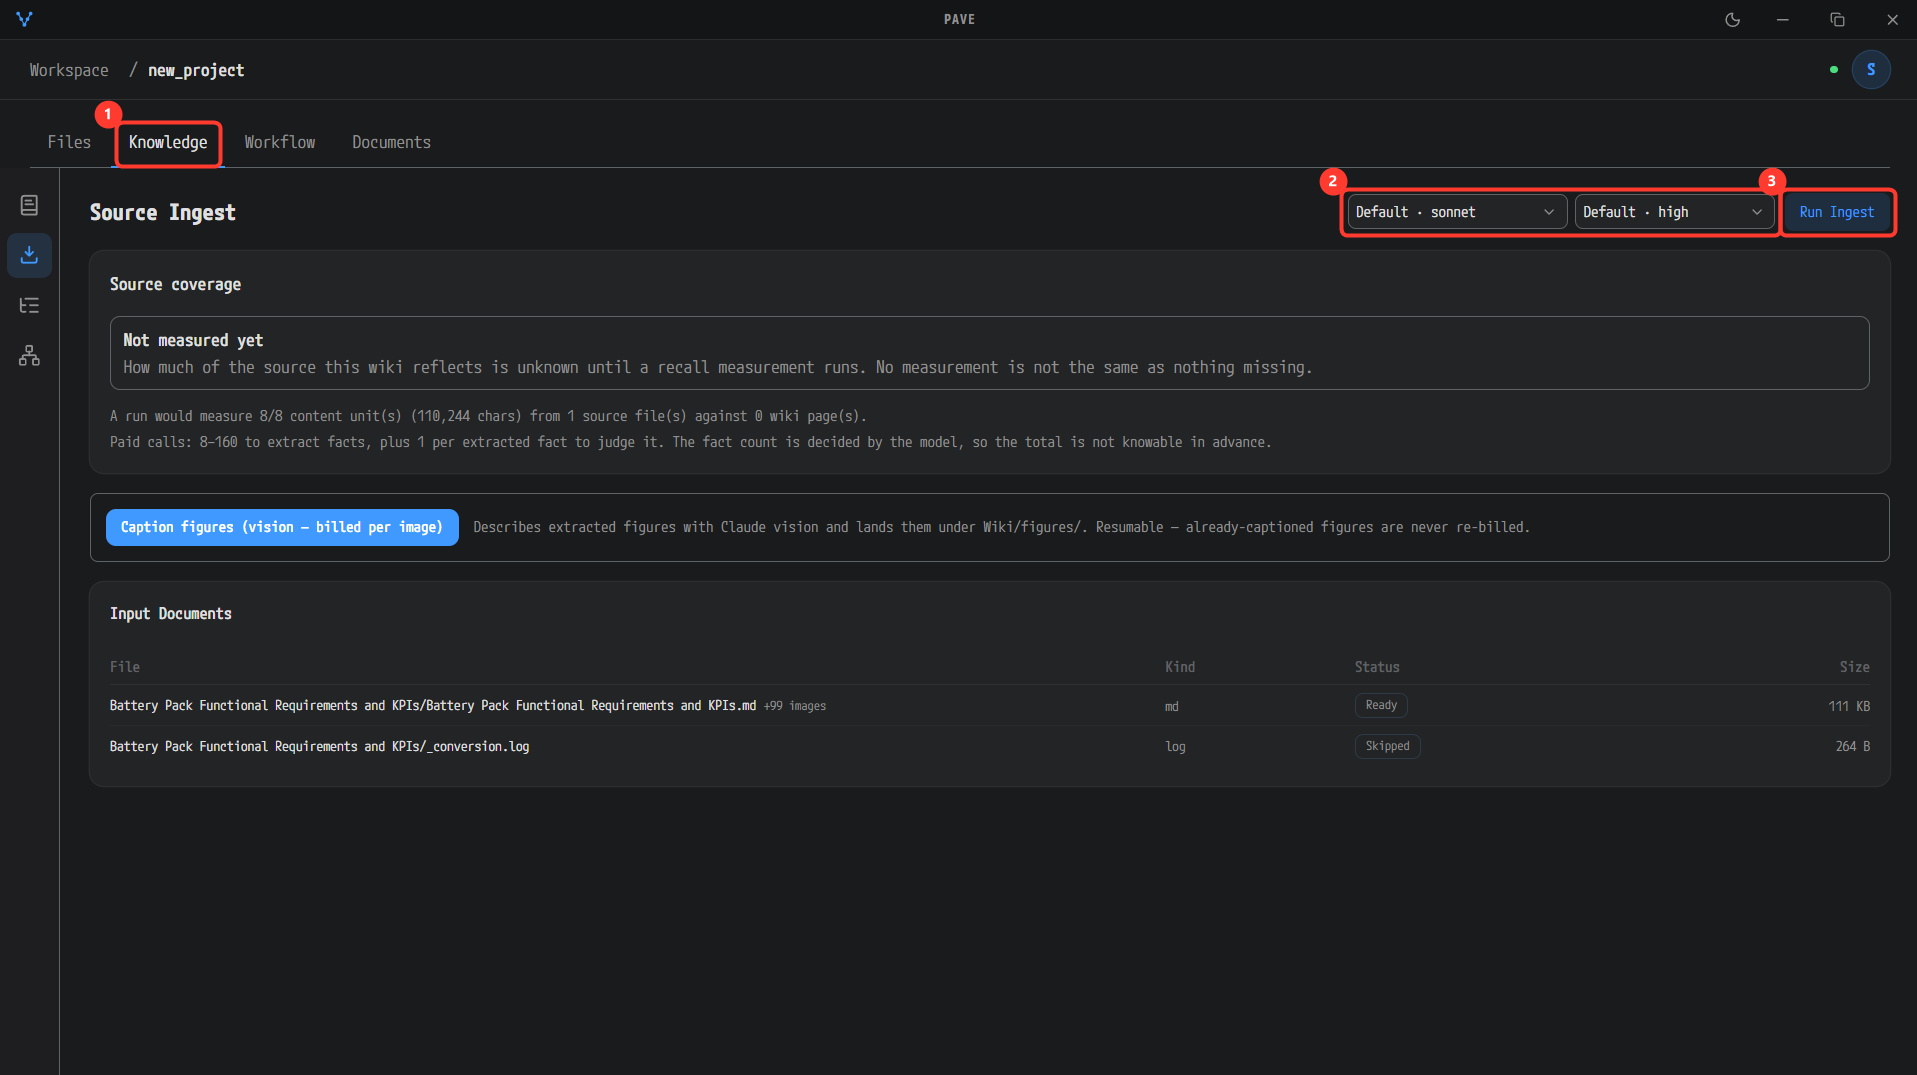
① Knowledge タブの Source Ingest 画面です。② モデル(Default · sonnet)と effort(Default · high)のドロップダウン、③ Run Ingest ボタン。下の Input Documents 表では、変換済みの .md が Ready、_conversion.log が Skipped です。Source coverage はまだ測定前のため Not measured yet です。
実行中の画面
実行が始まると、画面上部に Knowledge ingest の進行バナーが表示されます。進行文は ingest 0/1 · extracting <ファイル> のようにフェーズ・件数・現在のファイルを示し、その下に選んだモデルと effort が表示されます。バナーのボタンは次のとおりです。
- Pause — 進行中の Claude 呼び出しが終わった後、次の境界で停止します。すでに課金された作業は失われません。
- Stop — 実行を中断します。
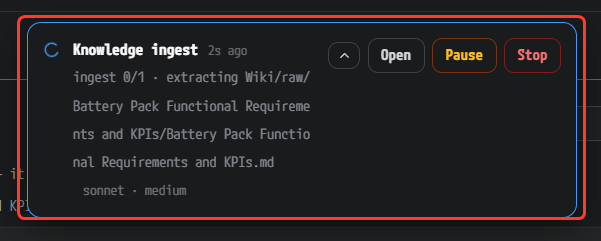
進行バナーです。Knowledge ingest ジョブが ingest 0/1 · extracting Wiki/raw/…/Battery Pack Functional Requirements and KPIs.md の状態にあり、下の行に sonnet · medium が見えます(この例は effort を medium に変えて実行しました)。右側の Open / Pause / Stop でジョブを操作します。
インジェストを一時停止したままアプリを終了しても、進行状況はディスクに残ります。アプリを再び開くと Unfinished ingest found バナーに完了したウィンドウ数(
N/M discovered window(s) done)と Resume ボタンが表示され、すでに終わった部分は再び課金されません。
完了画面の読み方
- 実行が終わると ① Ingest complete パネルが表示され、Preserved progress: N/N discovered window(s). Completed work is kept on disk. が示されます。その下の 1 行が結果の要約です(例: Ingested 128 page(s), 4 warning(s).)。
- ② 警告の一覧は失敗ではなく参考情報です。よく見られる 4 種類は次のとおりです。
| 警告(先頭部分) | 意味 |
|---|---|
format profile … | そのファイルから要求事項の表記規則や表の形式を推定できませんでした。ファイルは構造が少ない状態でインジェストされます。 |
LLM call #N failed transiently (retry i/N) | 呼び出しが 1 回失敗して再試行しました。実行が完了していれば無害です。 |
block delimiter glued mid-line … | モデルがページ区切りの前の改行を抜かしたため、そのページが前のページに吸収されました。 |
source_ref gate: injected N [INFO-INSUFFICIENT: source_ref missing] mark(s) … | 根拠なく書かれた段落にマークを入れました。ページは削除されずに保持されます。 |
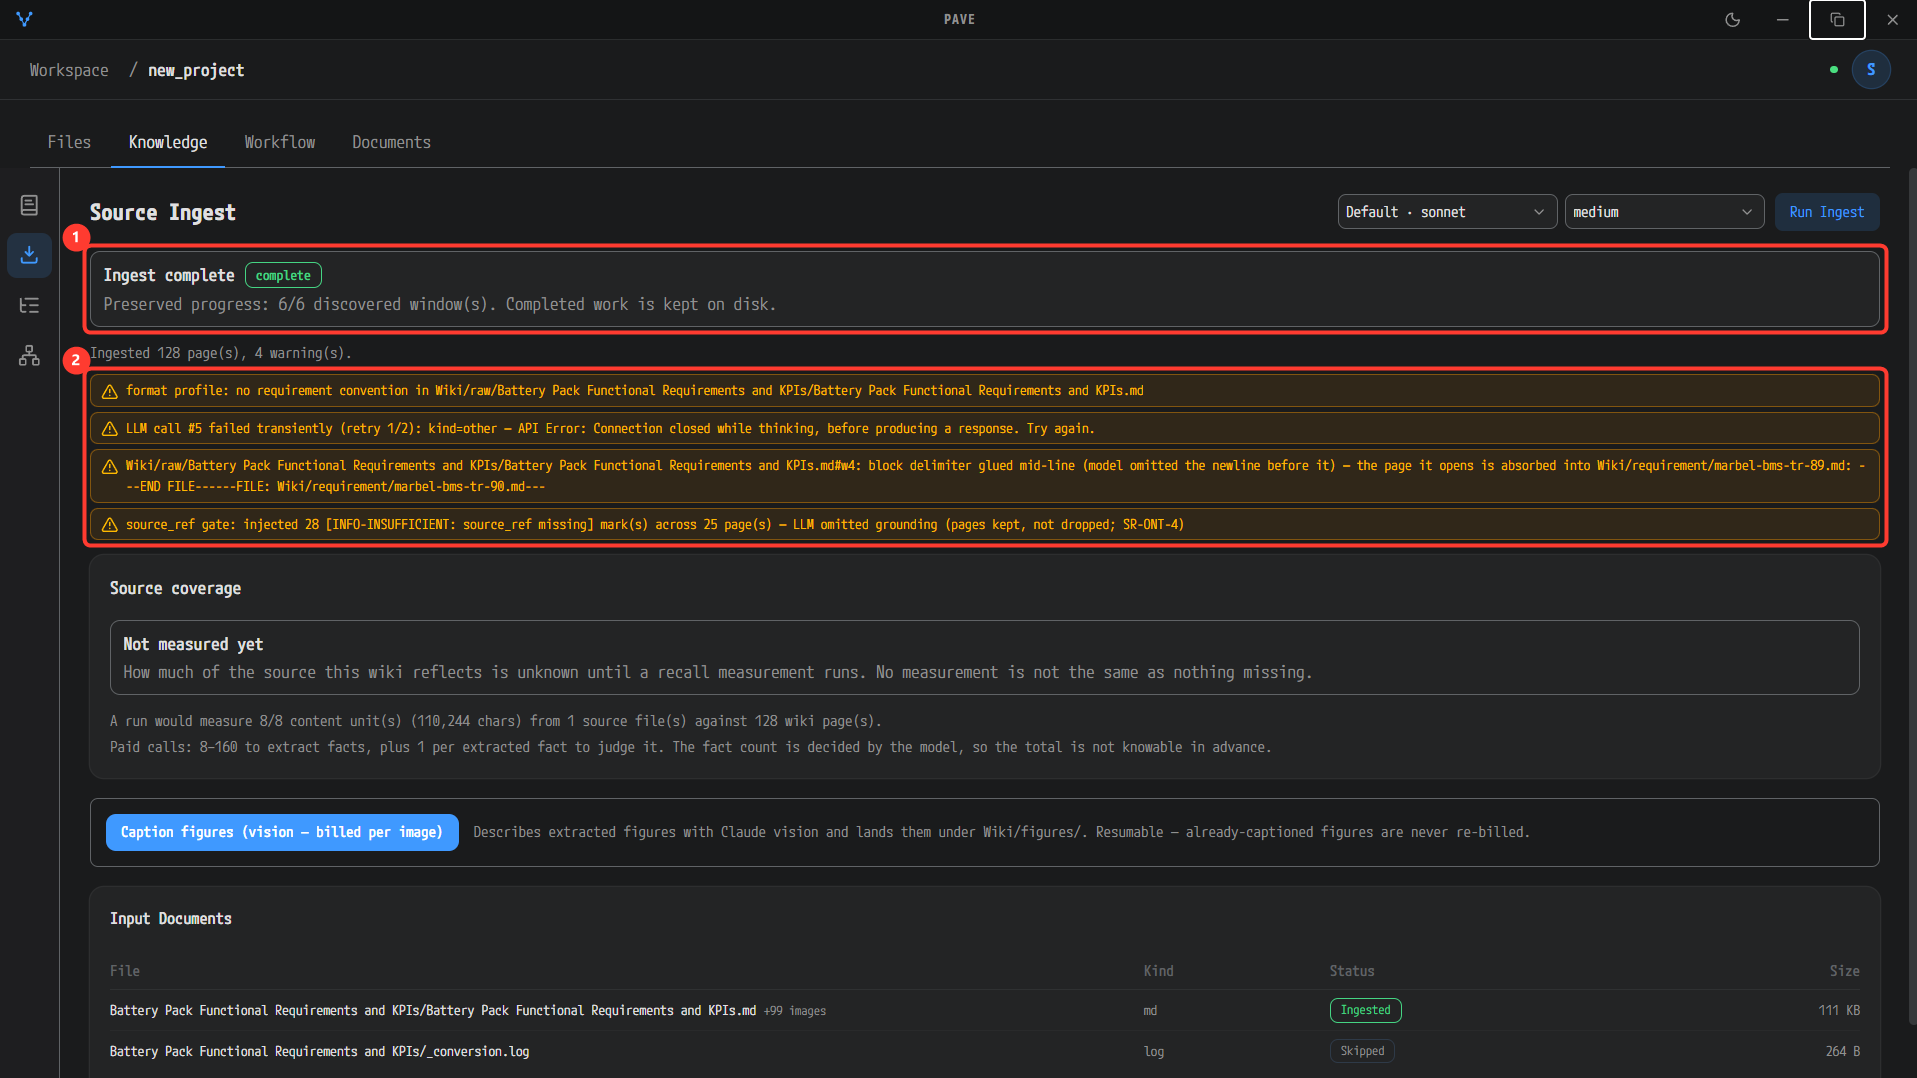
① Ingest complete パネル — Preserved progress: 6/6 discovered window(s). Completed work is kept on disk. と、その下の要約 Ingested 128 page(s), 4 warning(s). ② 4 件の警告は、上の表の 4 種類が 1 つずつ出たものです。Input Documents の .md の状態は Ingested に変わり、Source coverage の予測文は against 128 wiki page(s) で終わるようになりました。
作られたページを確認する
- 左のレールの 1 番目 ① Knowledge アイコンを押します。左にページ一覧(タイプ別: CONCEPT、REQUIREMENT …)、中央に RELATIONSHIP GRAPH、右に選んだページの内容が表示されます。
- ページ本文の段落の末尾には ②
(source_ref: <ファイル> <位置>)チップが付いています。このチップが、その段落の根拠となった入力文書と位置です。根拠なく書かれた段落には代わりに[INFO-INSUFFICIENT: …]マークが付きます。
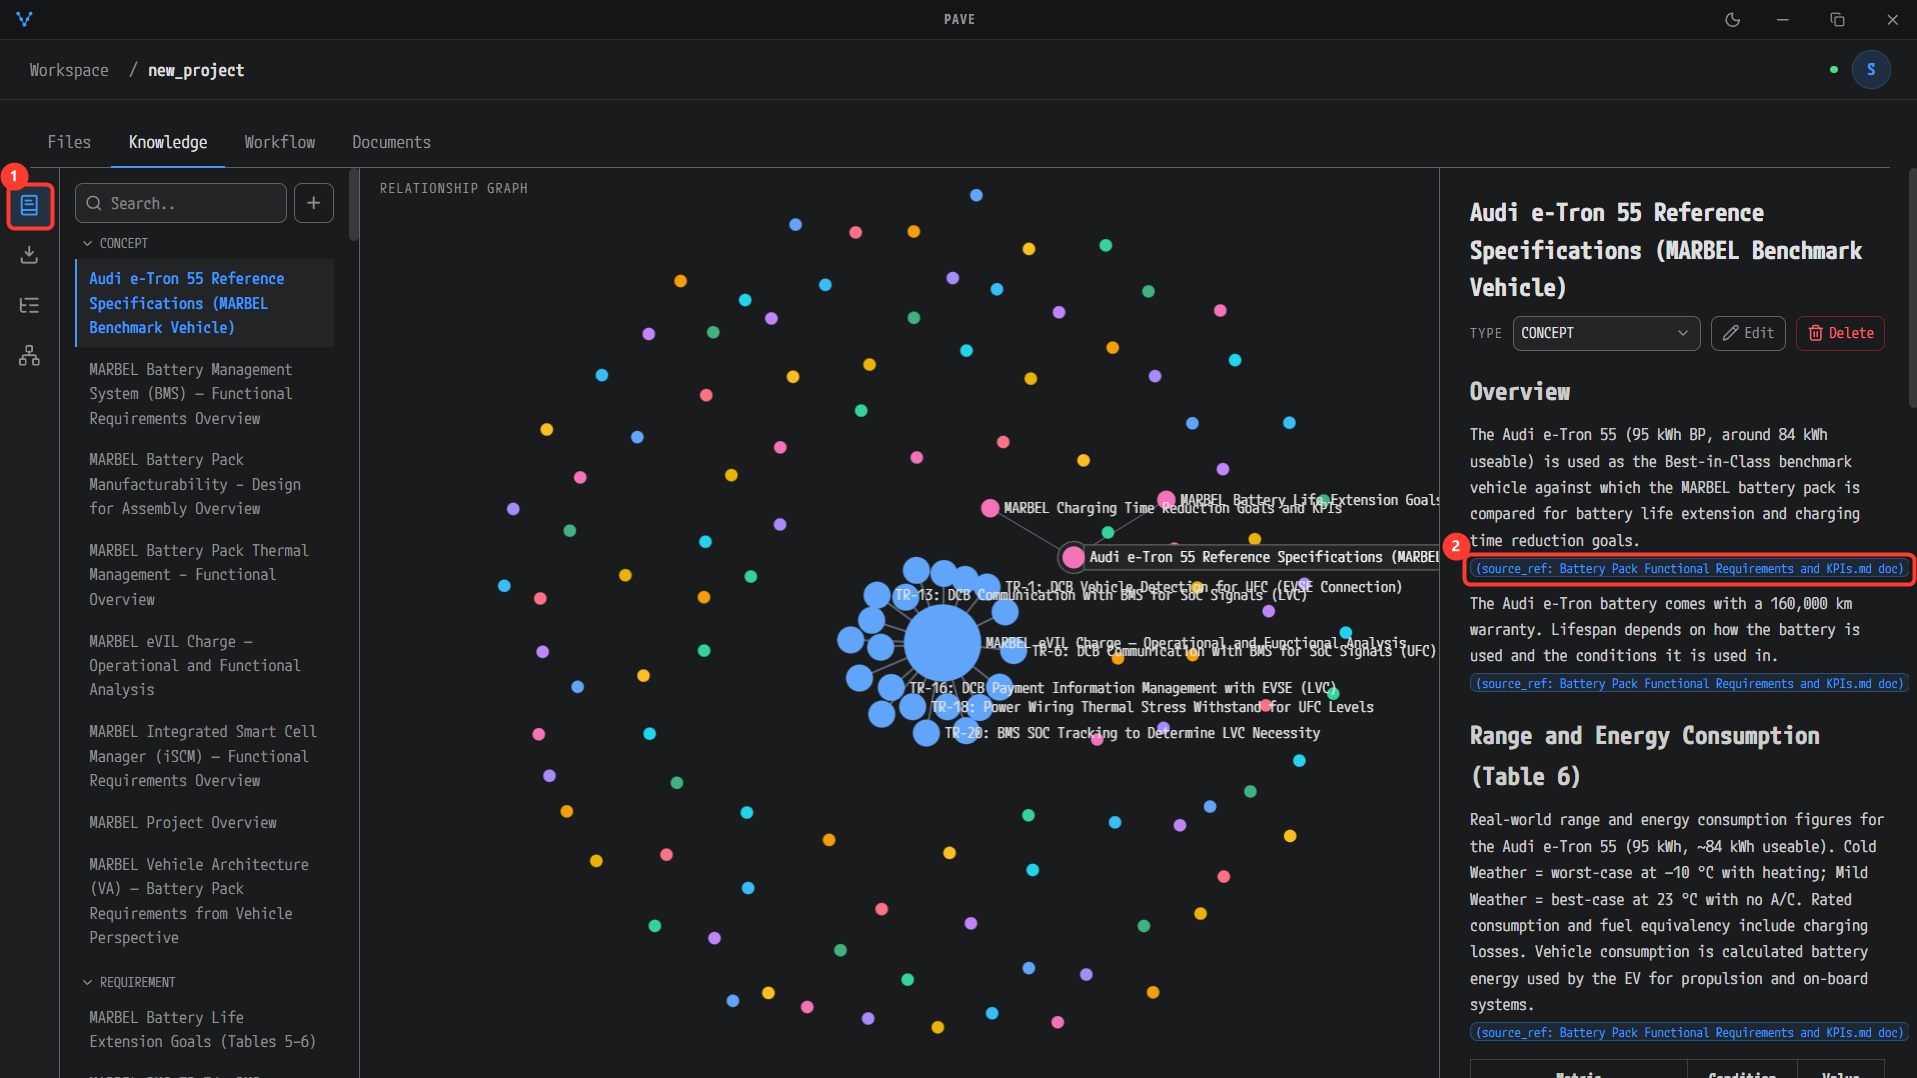
① レールの Knowledge アイコンを押すと 3 列の画面になります。左の一覧は CONCEPT、REQUIREMENT のようなタイプ別にまとめられ、中央の RELATIONSHIP GRAPH はページ間の関係です。右のページ(タイプのドロップダウンは CONCEPT)の段落ごとに ② (source_ref: Battery Pack Functional Requirements and KPIs.md doc) チップが付いていて、どの文書から来たかが分かります。TYPE 行の Edit / Delete でページを直接修正したり削除したりできます。
図のキャプション生成(Caption figures)
文書変換の際に Wiki/raw/<文書>/images/ に抽出された図には、まだ説明がありません。Caption figures は Claude vision で図ごとに説明を作り、Wiki/figures/<文書>.md に追加します。
- Source Ingest 画面(レールの Ingest アイコン)で Caption figures (vision — billed per image) ボタンを押します。
完了パネルの下にある Caption figures (vision — billed per image) ボタンです。横の説明のとおり、抽出された図を Claude vision で説明して Wiki/figures/ に入れ、すでにキャプションがある図には再び課金しません。
- 実行中はボタンが Captioning figures… に変わり、無効になります。終わるとボタンの下に Last run: で始まる結果行が表示され、適用された数、判読可能・情報不足の数、装飾用として飛ばした数、課金された呼び出し数を示します。
実行中はボタンが Captioning figures… に変わります。終わるまで再び押すことはできません。
画像ごとに課金されます。 ただし同じ図に 2 回課金されることはありません — 処理台帳に記録された図は呼び出し前に飛ばされ、台帳がなくても
Wiki/figures/ファイル内のマーカーを見て再び追加しません。途中で止まっても、再び押せば残りの図だけを処理します。
次のステップ
ナレッジベースの準備ができました。ワークフローの実行で Workflow タブの Run から A-SPICE 作業成果物の生成を始めます。